Documenti PDF

OCR in PDF

OCR in PDF trasforma scansioni, foto di documenti, TIFF multipagina e PDF scansionati in un PDF in cui il testo si cerca, si seleziona e si copia. Ogni pagina passa da quattro passaggi, in quest'ordine: raddrizzamento (correzione prospettica delle foto storte o dell'inclinazione delle scansioni, con gli angoli correggibili a mano), orientamento automatico, isolamento delle immagini (foto, timbri, loghi, che non si scambiano per testo) e riconoscimento del testo con Tesseract 5. Tutto avviene sul computer; per le stampe rovinate e la scrittura a mano si può aggiungere la rilettura di un modello visivo locale.

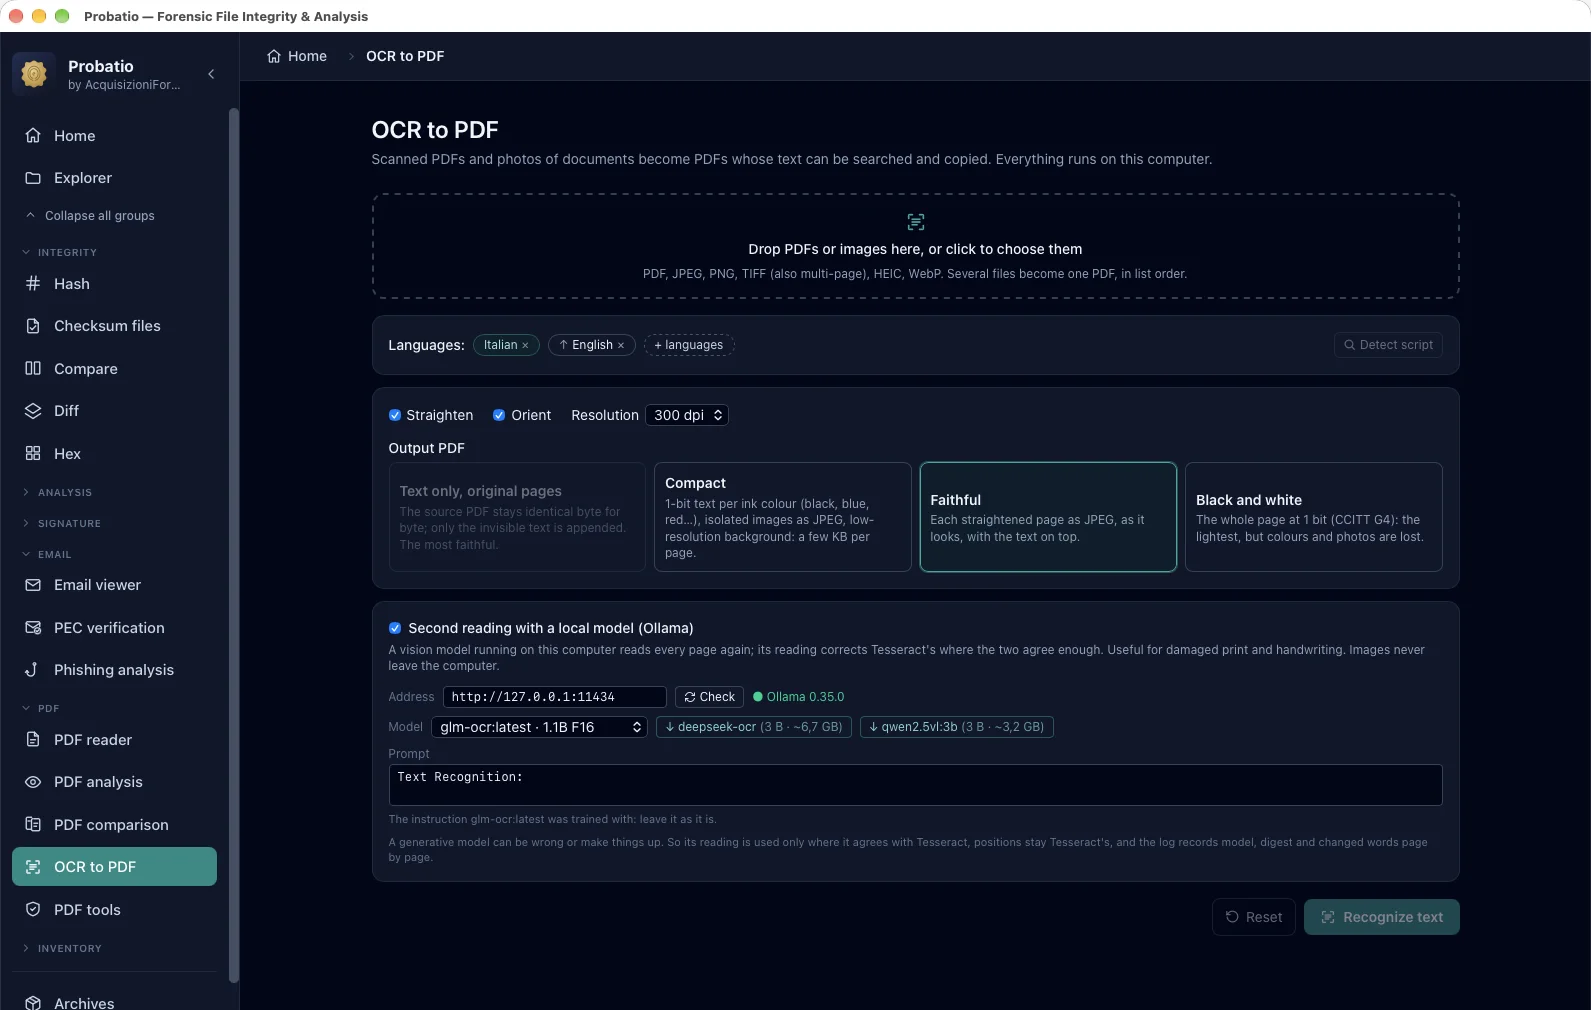
Il modulo OCR in PDF: lingue italiano e inglese, raddrizzamento e orientamento attivi, i quattro modi di salvare con Fedele selezionato, rilettura con un modello locale servito da Ollama su 127.0.0.1
Lingue, raddrizzamento e orientamento, i quattro modi di salvare e la rilettura facoltativa con un modello locale (Ollama su 127.0.0.1): l'immagine della pagina non lascia il computer.
Cosa fa

Cosa fa il modulo OCR in PDF

122 lingue, anche insieme

Italiano e inglese sono inclusi; le altre 120 lingue si scaricano una volta sola, con verifica dell'impronta, e poi restano sul computer. Probatio riconosce la scrittura della pagina (latina, cirillica, araba, greca, cinese…) e propone le lingue adatte.

Raddrizzamento e orientamento

Il foglio fotografato in prospettiva torna rettangolare, la scansione inclinata torna dritta, la pagina capovolta o di traverso viene girata. Il raddrizzamento automatico è fatto per scattare solo sui documenti, non sulle foto qualunque.

Rilettura con un modello locale

Facoltativa: un modello visivo servito da Ollama sul tuo computer rilegge ogni pagina e corregge Tesseract. Probatio accetta solo un indirizzo locale, quindi le immagini non lasciano la macchina. Il testo del modello si usa solo dove concorda con Tesseract e mai su una pagina bianca, perché un modello generativo può inventare.

Quattro modi di salvare

Fedele: l'immagine originale, e un JPEG non ritoccato entra nel PDF identico byte per byte. Compatto: testo nitido e figure separate, file molto più piccolo. Bianco e nero: il più leggero, per il solo testo. Solo testo: aggiunge il testo al PDF originale senza toccarlo, che resta intatto all'inizio del file nuovo.

Avvisa quando la sorgente è povera

Se l'immagine ha poca risoluzione, Probatio avvisa che «Fedele» resterà sgranato e propone le modalità che ridisegnano il testo nitido. Le pagine di un PDF già digitali, con testo vero, non si rifanno.

Finestra di lavoro

Avanzamento, pagine, anteprima con le parole colorate per confidenza, testo riconosciuto e console dell'attività, in una finestra propria.

Si salva solo ciò che scegli

Il PDF e, a richiesta, il testo (.txt) e il registro (.ocr.json) con le impronte dei file e, per ogni pagina, raddrizzamento, rotazione, lingue, confidenza e modello locale usato, con il numero di parole cambiate.
Passo per passo

Come funziona

  1. Aggiungi PDF scansionati, foto o TIFF: dalla barra laterale o col tasto destro da Explorer.
  2. Scegli le lingue, il modo di salvare e, se vuoi, la rilettura con il modello locale; controlla gli angoli delle pagine raddrizzate.
  3. Avvia e segui le pagine nella finestra di lavoro, poi salva il PDF, con testo e registro se ti servono.
FAQ

Domande frequenti

Le pagine vengono inviate a un servizio online?
No. Il riconoscimento con Tesseract avviene sul computer. La rilettura facoltativa usa un modello servito da Ollama sullo stesso computer: Probatio accetta solo un indirizzo locale. In rete vanno soltanto i file delle lingue, scaricati una volta e verificati con l'impronta.
Il PDF originale resta intatto?
Con «Solo testo», disponibile quando in ingresso c'è un solo PDF, sì: il testo si aggiunge in coda e il file di partenza resta identico all'inizio di quello nuovo. Con «Fedele» un JPEG non ritoccato entra identico byte per byte; una pagina raddrizzata o ruotata è invece un'immagine nuova, e il registro lo dichiara.
Il modello locale può inventare il testo?
Un modello generativo può farlo, per questo Probatio ne usa il testo solo dove concorda con quello di Tesseract e mai su una pagina quasi bianca. Il registro scrive per ogni pagina il modello usato, con la sua impronta, e quante parole ha cambiato.